Análisis de afinidad de votantes mediante el uso de IA (LLMs y RAG)
🌐 Publicación
📝 Descripción
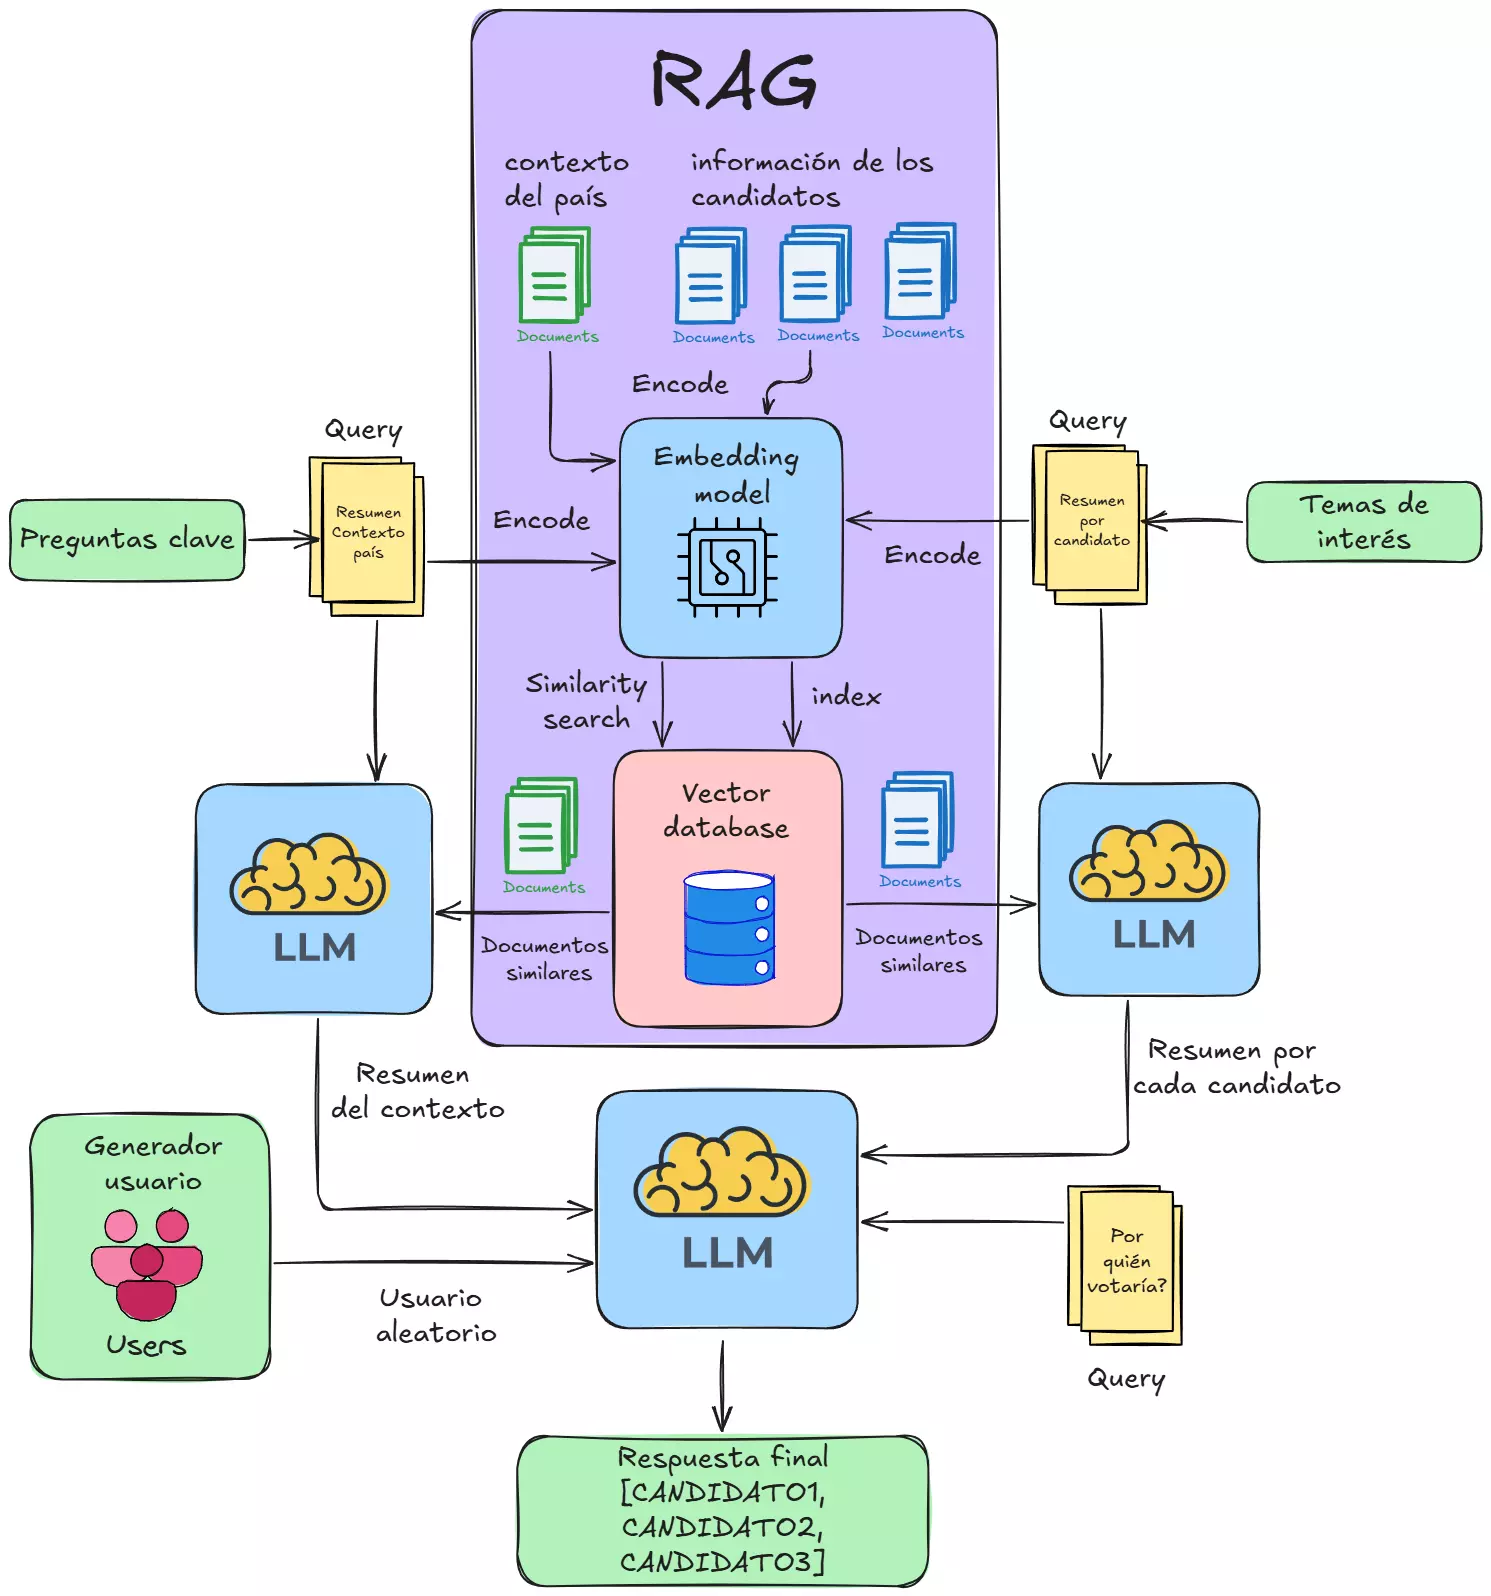
Proyecto exploratorio que utiliza un modelo de lenguaje (LLM) potenciado con la técnica de Retrieval-Augmented Generation (RAG) para analizar y simular la afinidad entre perfiles de votantes ficticios y candidatos presidenciales en Chile. El objetivo no era predecir resultados electorales, sino investigar el potencial de estas tecnologías para analizar escenarios sociales complejos.
🛠️ Metodología
- Recopilación de Datos: Se construyó una base de conocimiento con entrevistas, planes de gobierno y noticias de los candidatos (~150,000 caracteres por candidato), junto con información sobre el contexto nacional y las preocupaciones de los votantes (~50,000 caracteres).
- Generación de Perfiles: Se crearon 1,000 perfiles de votantes ficticios con características y prioridades aleatorias para simular un electorado diverso.
- Procesamiento y Consulta: Mediante un prompt diseñado específicamente, se le pidió al LLM que evaluara la afinidad de cada perfil de votante con las propuestas de los candidatos, considerando el contexto del país.
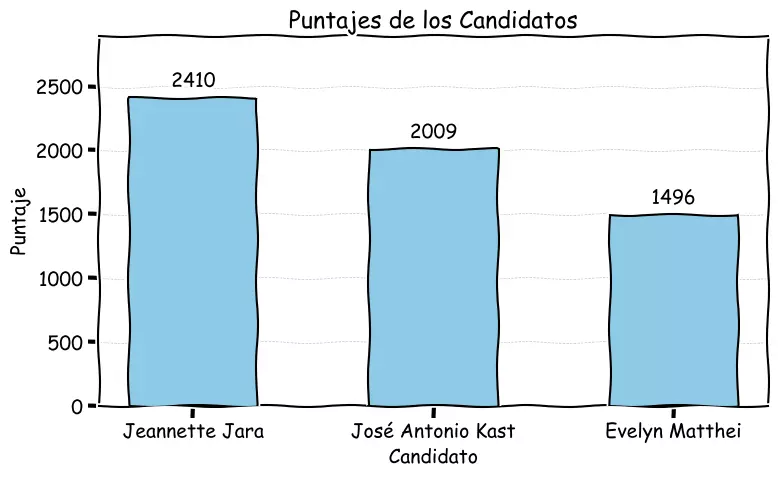
- Puntuación y Análisis: Se asignó un puntaje a cada candidato según la afinidad resultante (3 puntos para la más alta, 2 para la segunda y 1 para la última), permitiendo una cuantificación de los resultados.
💡 Tecnologías utilizadas
- Modelo de Lenguaje (LLM): Gemma3 (versiones 4b y 1b-it-fp16)
- Base de Datos Vectorial: ChromaDB
- Modelo de Embeddings:
all-MiniLM-L6-v2 - Conceptos Clave: RAG (Retrieval-Augmented Generation), Prompt Engineering, Data Science
- Lenguaje: Python
📈 Resultados y Conclusiones
El modelo asignó puntuaciones de afinidad a los candidatos (ej. Jeannette Jara: 2410, José Antonio Kast: 2009, Evelyn Matthei: 1496). El proyecto demostró con éxito que la combinación de LLM y RAG es una herramienta viable para explorar escenarios complejos, abriendo camino a su uso en contextos analíticos más allá de la simple generación de texto.
🔮 Trabajo Futuro
Se identificaron áreas de mejora que limitaron el rendimiento pero que revelan oportunidades futuras:
- Calidad de la Información: Aumentar la cantidad y mejorar el procesamiento de los datos.
- Potencia del Modelo: Utilizar LLMs más grandes y precisos.
- Optimización de Prompts: Refinar las instrucciones para mejorar la lógica y precisión del modelo.
- Complejidad de Perfiles: Desarrollar perfiles de votantes más elaborados para obtener resultados más segmentados y precisos.